
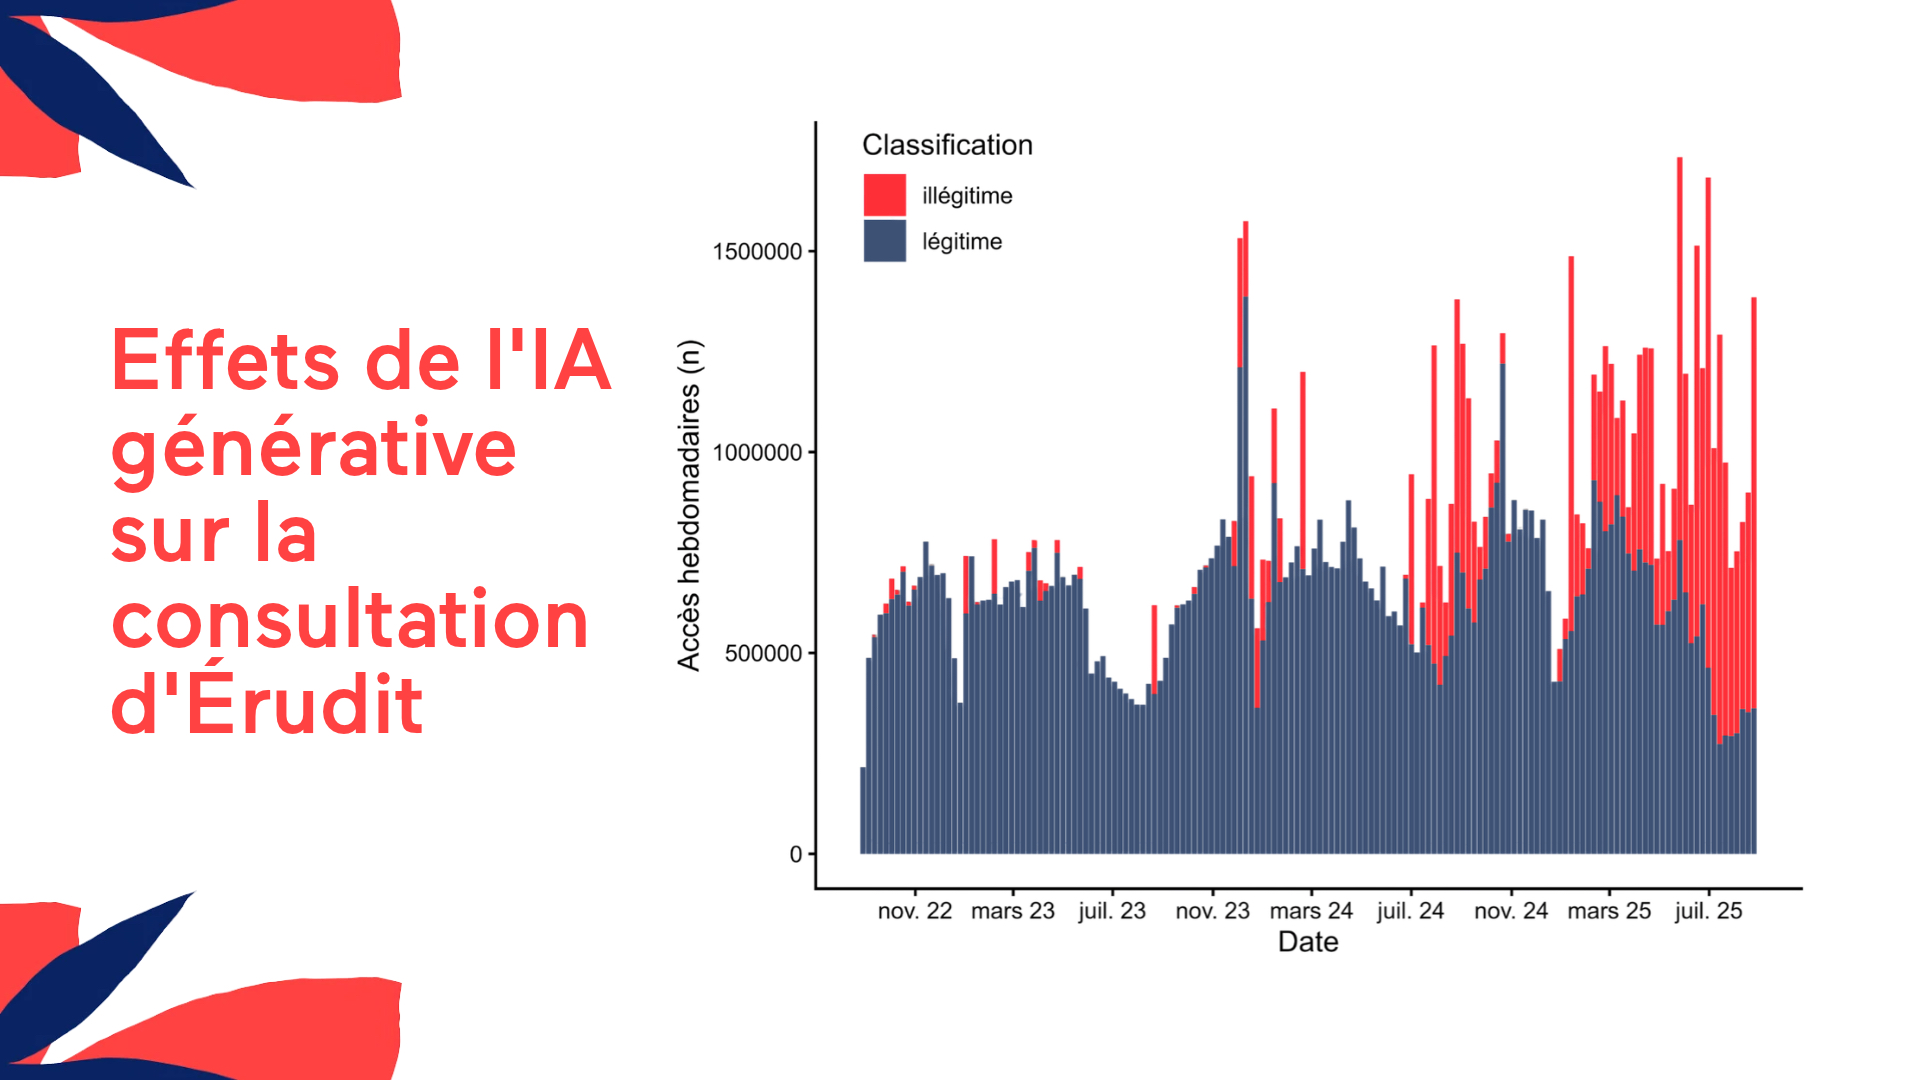
L’intelligence artificielle transforme la façon dont les connaissances scientifiques circulent. Quels effets ces nouveaux usages ont-ils sur les publications diffusées sur Érudit? Une première analyse de nos données nous permet de mieux comprendre les changements en cours et ce qu’ils signifient pour la circulation des savoirs.
Publication rédigée par Simon van Bellen, Conseiller principal – recherche chez Érudit. orcid.org/0000-0002-1698-8530
Le phénomène de la recherche sans clic
La croissance rapide des applications intégrant de l’intelligence artificielle transforme la publication scientifique. Non seulement elle affecte la rédaction et l’évaluation par les pairs, elle altère également le repérage et l’appropriation de l’information par les internautes.
De nombreux outils de recherche intègrent désormais des fonctionnalités d’IA générative capables de fournir directement une synthèse de documents en réponse à une requête. Ces nouvelles fonctionnalités, qui favorisent la « recherche sans clic » (zero-click search), tendent à réduire la consultation de la source originale. Ce phénomène, très récent, est encore relativement peu étudié. Cependant, certains chiffres sont assez parlants : la disponibilité d’une synthèse de Google AI Overviews pourrait réduire le nombre de clics externes de près de 40 %. La recherche sans clic fait en sorte que de nombreuses organisations présentant des contenus originaux en ligne, allant de Wikipédia aux Presses de l’Université d’Oxford, enregistrent des baisses significatives de visites. La plateforme de diffusion scientifique Cairn a rapporté une baisse de 26 % des consultations de ses revues savantes entre 2024 et 2025.
L’autre effet majeur de l’IA générative sur la communication savante est la pression croissante exercée par les robots sur les infrastructures numériques. Ces robots moissonnent massivement les pages web pour alimenter les grands modèles de langage sur lesquels reposent les applications d’IA générative. Les pratiques de ces robots, qui ne reflètent pas un usage humain ni un intérêt particulier pour la recherche scientifique, menacent la stabilité des sites de diffusion, qui doivent parfois limiter les accès aux internautes pour protéger leur infrastructure technologique. Des ressources diverses comme l‘Open Science Framework (Center for Open Science), Zenodo et la bibliothèque de l’Université Duke aux États-Unis ont récemment fait état des difficultés causées par ces accès massifs par robots.
La recherche sans clic et la multiplication des accès par robots ont donc des effets opposés sur la mesure et le suivi des consultations. Alors que la recherche sans clic tend à réduire les visites vers les sources originales, le moissonnage massif tend, à l’inverse, à gonfler artificiellement le nombre d’accès enregistrés.
Ce que nous observons sur Érudit
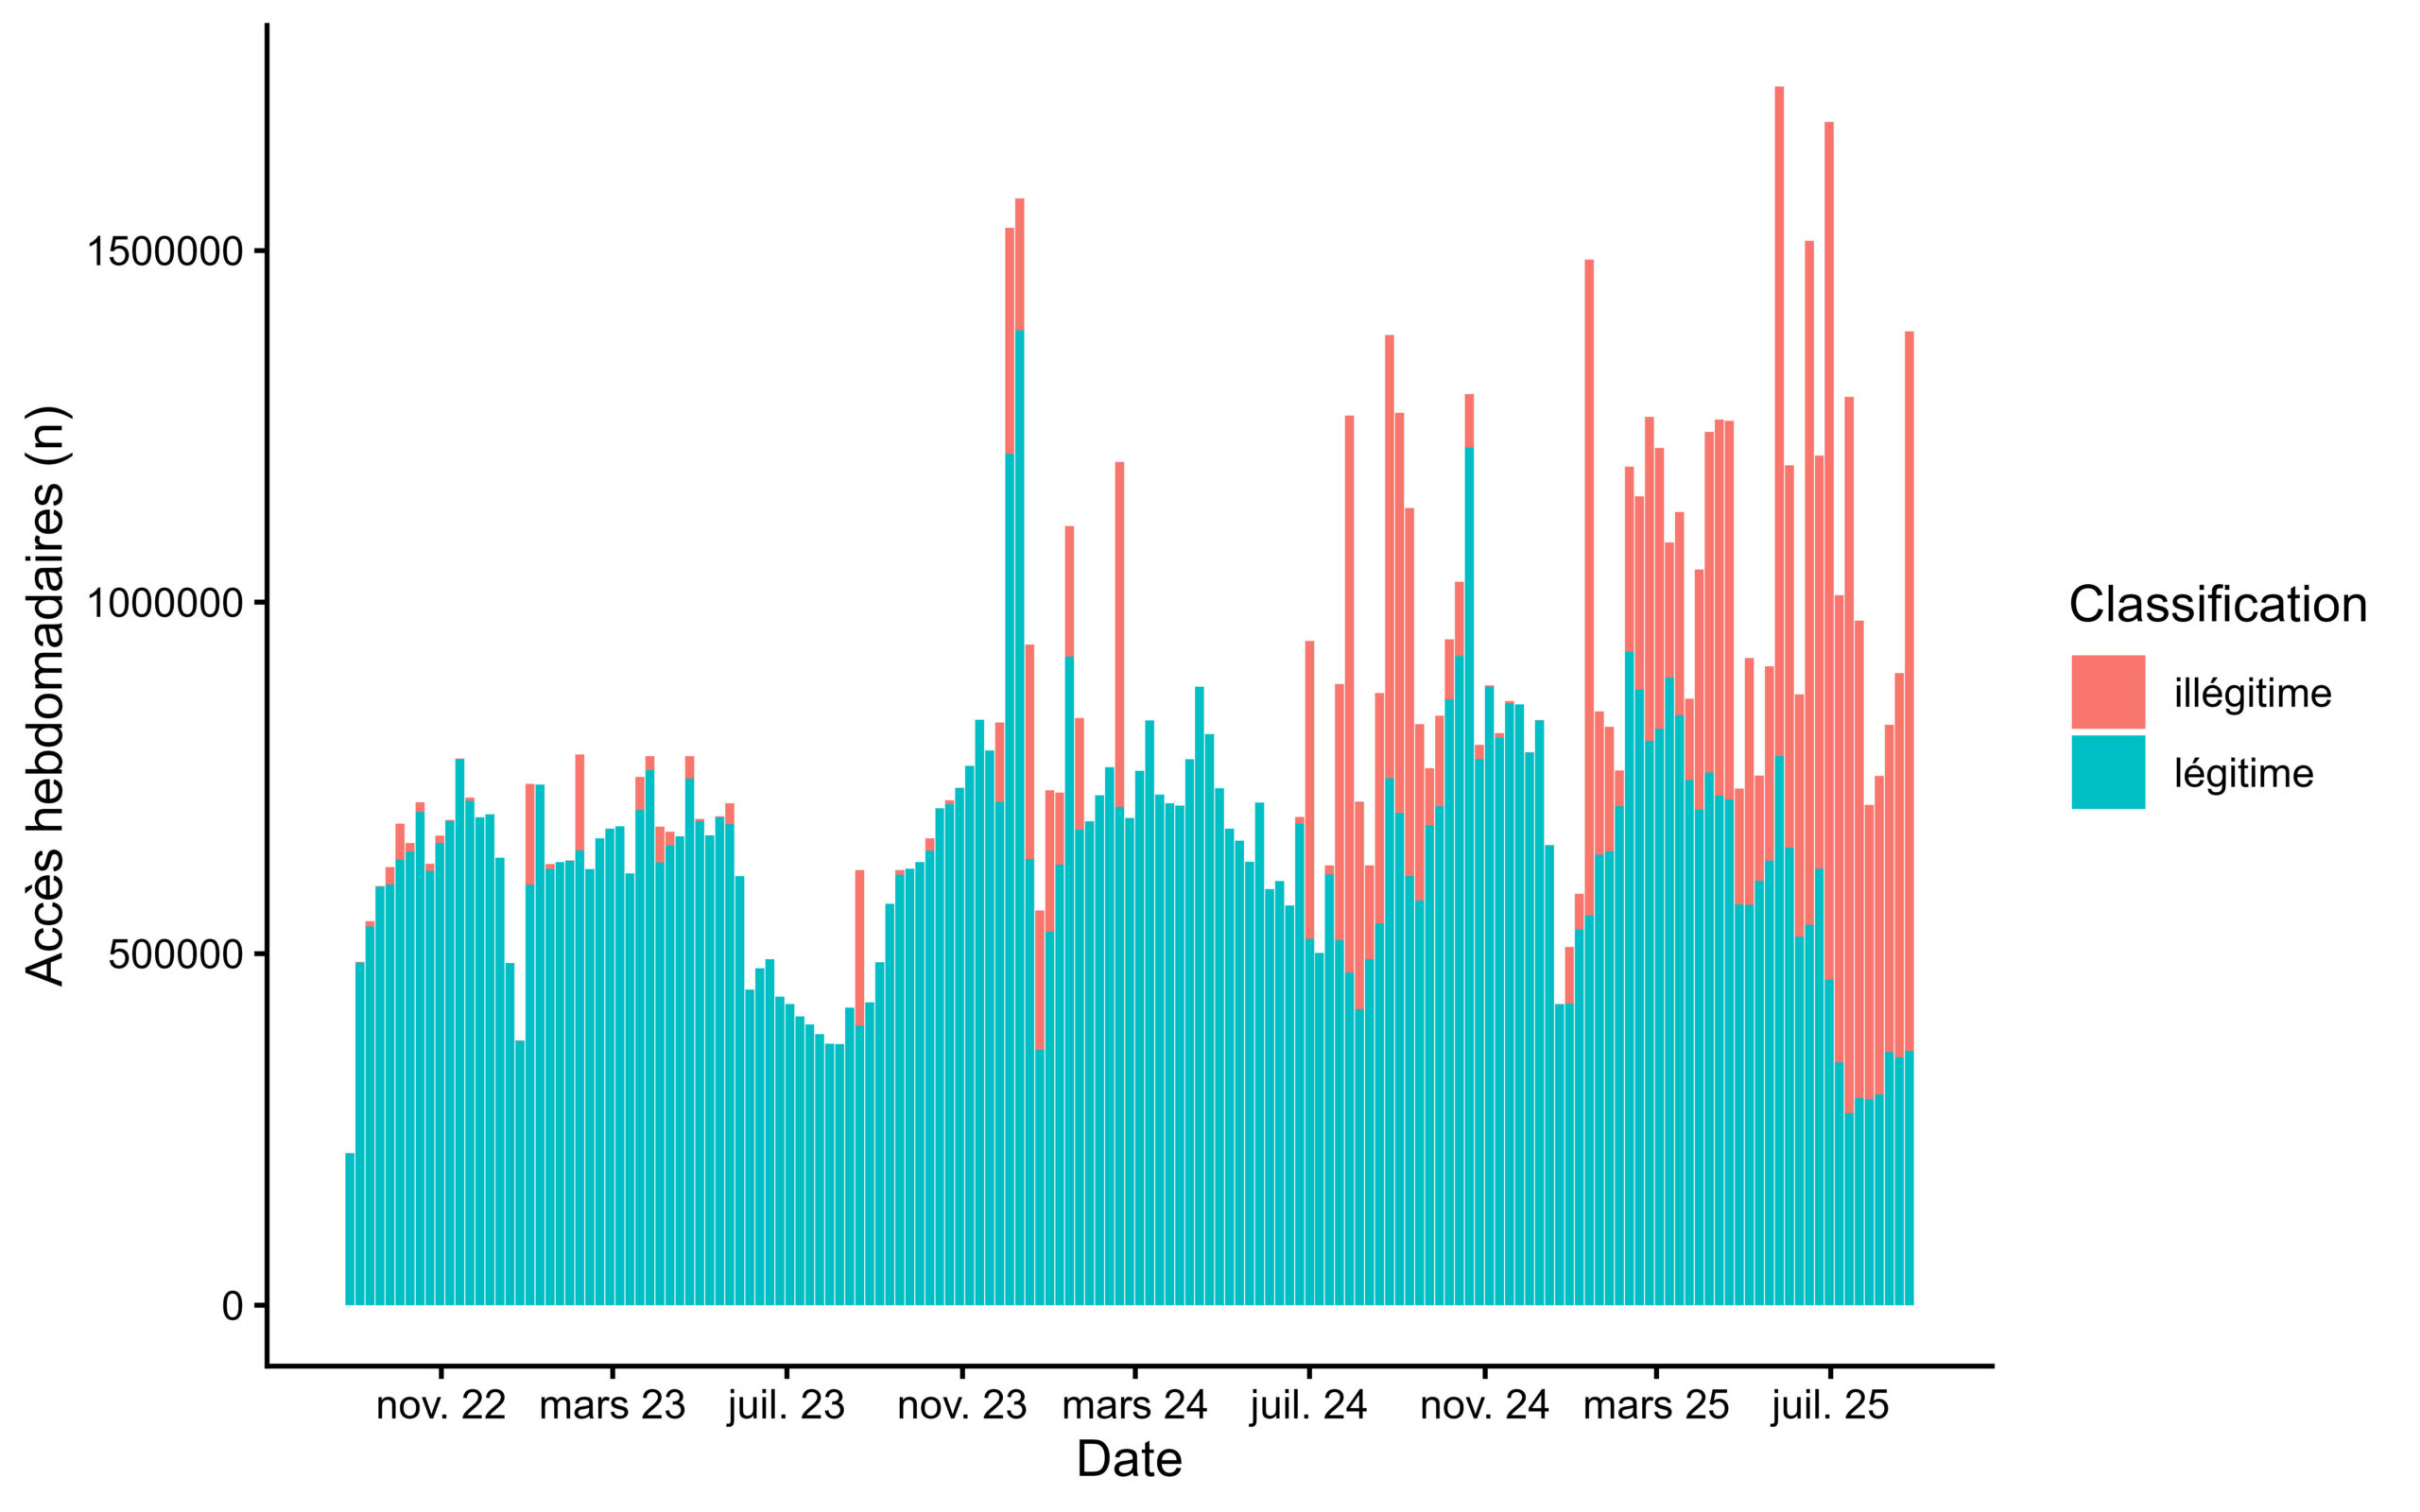
Érudit n’échappe pas à ces tendances. Au cours de la première moitié de 2025, nos systèmes ont enregistré des volumes d’accès particulièrement élevés qui semblaient, à première vue, légitimes. Nous avons toutefois constaté qu’une part importante de ce trafic provenait en réalité de robots qui moissonnaient massivement le texte intégral des articles scientifiques diffusés sur notre plateforme. Lors de certaines journées de l’été 2025, jusqu’à 80 % des accès enregistrés sur Érudit provenaient de ces robots.
L’ampleur et la rapidité du phénomène ont représenté un défi considérable pour notre infrastructure. Nos méthodes de détection ne permettaient alors pas d’identifier tous ces accès automatisés, dont une partie a été catégorisée comme légitime (Figure 1). Autrement dit, les données de cette période, compilées selon la norme internationale COUNTER pour les accès aux contenus web, surestimaient le nombre de consultations que nous pouvions réellement attribuer à des internautes. C’est un phénomène qu’Érudit n’était d’ailleurs pas seul à rencontrer : la multiplication rapide des robots moissonneurs a pris de nombreuses infrastructures de court.
Face à cette nouvelle réalité, nous avons renforcé les mécanismes de protection des publications que nous diffusons en déployant Anubis à l’automne 2025. Ce logiciel libre permet de filtrer automatiquement une grande partie des accès correspondant à un moissonnage non autorisé, avant même qu’ils atteignent la plateforme. En plus de protéger la stabilité de la plateforme, il facilite le travail de détection réalisé par nos équipes et contribue ainsi à produire des statistiques plus représentatives de la consultation réelle.
À partir de l’automne 2025, et à la suite de ces mesures de protection, nos données statistiques ont commencé à montrer une baisse significative du nombre de consultations par rapport à l’année précédente. Une partie de cette baisse était attendue : en filtrant mieux les robots, nous comptabilisions moins d’accès qui n’auraient jamais dû être considérés comme des consultations légitimes. Cependant, l’ampleur de la baisse observée nous a amenés à nous demander si ce meilleur filtrage suffisait à tout expliquer, ou si une évolution des habitudes de consultation des internautes était également à l’œuvre. Pour départager ces deux phénomènes et mieux comprendre l’évolution de nos statistiques, nous avons mené une première analyse des données de consultation sur Érudit.
La baisse des accès : une histoire de robots ou d’humains ?
L’objectif de cette analyse était de répondre à une question : quelle part de la baisse des consultations observée depuis le déploiement d’Anubis peut être attribuée à un meilleur filtrage des robots, et quelle part pourrait refléter une réelle évolution des habitudes de consultation des internautes? Pour y répondre, nous avons comparé les consultations de contenus scientifiques sur erudit.org pendant deux périodes : du 1er octobre 2024 au 30 juin 2025, avant le déploiement d’Anubis, et du 1er octobre 2025 au 30 juin 2026, après son déploiement. L’analyse complète, incluant la méthodologie, est disponible dans une note de recherche déposée dans Papyrus, le dépôt institutionnel de l’Université de Montréal.
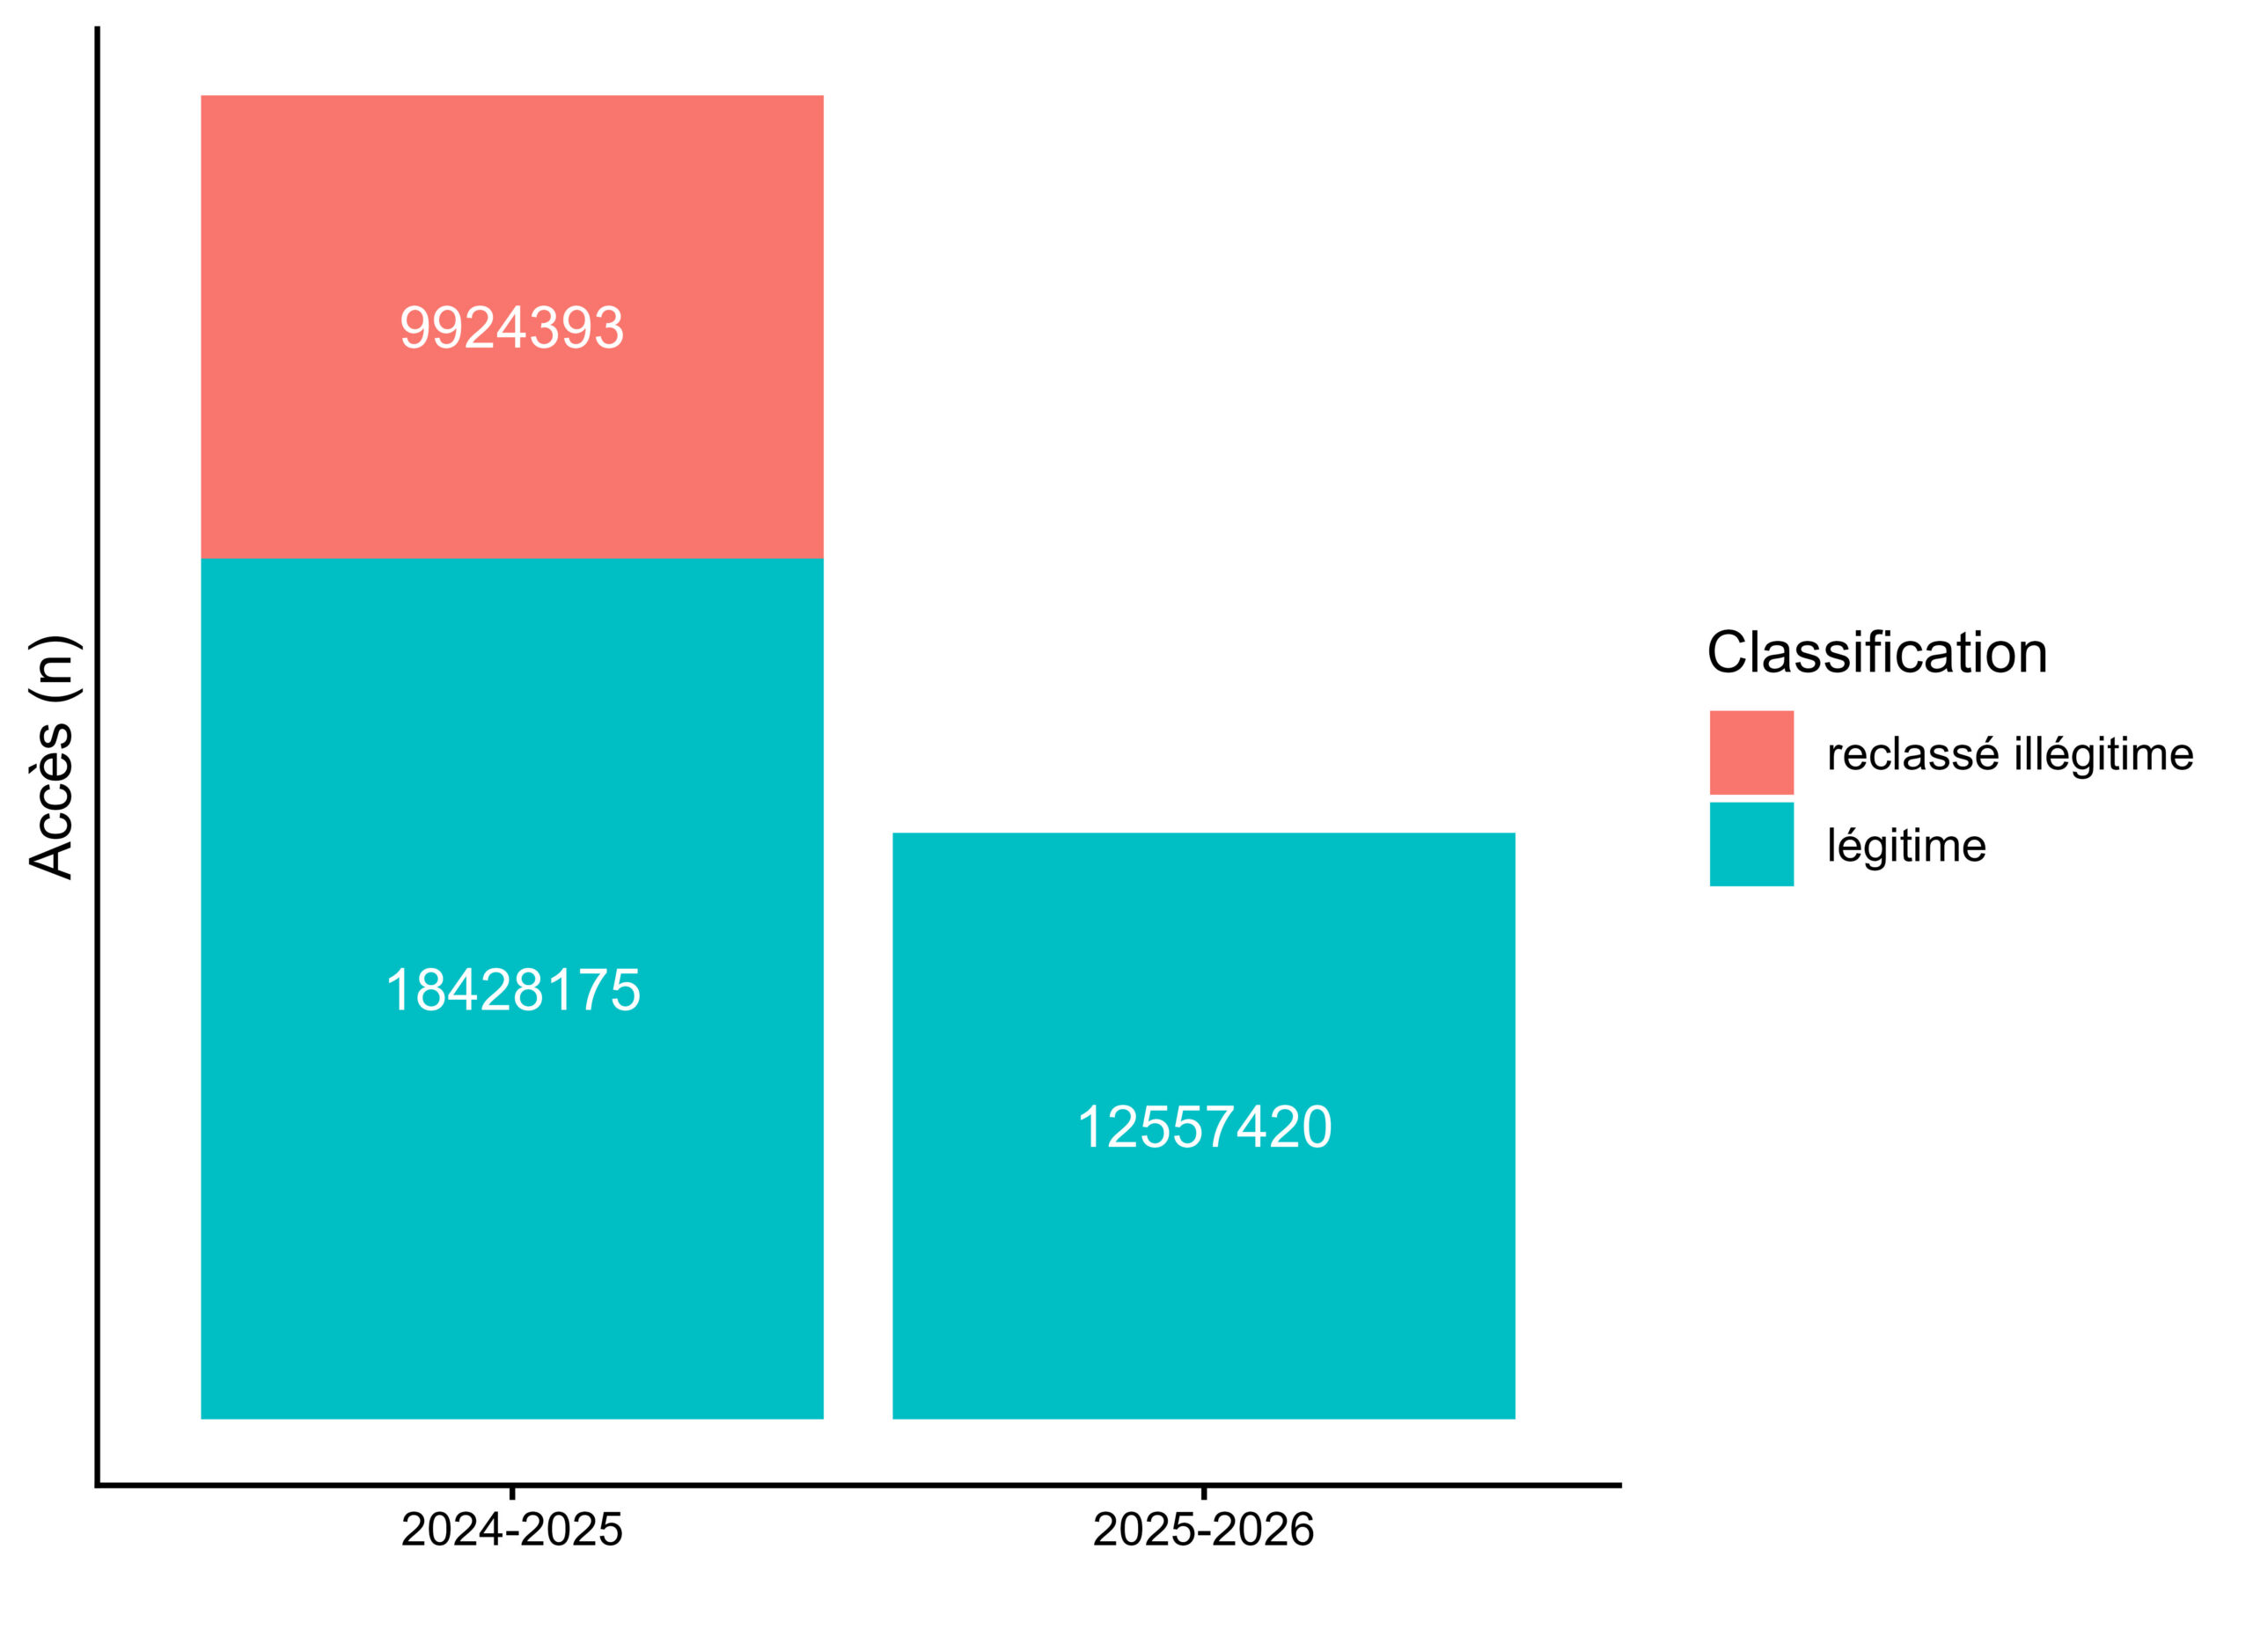
Entre 2024-2025 et 2025-2026, le nombre d’accès enregistrés est passé d’environ 28,4 millions à 12,6 millions (Figure 2). Cette baisse s’explique davantage par un meilleur filtrage des robots que par un changement de comportement des internautes : environ 63 % de la baisse enregistrée dans nos statistiques serait attribuable à un meilleur filtrage des accès automatisés, tandis que les 37 % restants correspondraient à une diminution des consultations légitimes. Autrement dit, environ 35 % des accès (9,9 millions) que nous avions initialement considérés comme légitimes en 2024-2025 étaient probablement illégitimes. Au final, les accès légitimes sur Érudit auraient diminué d’environ 32 % en un an, de 18,4 millions à 12,6 millions (Figure 2), une baisse du même ordre que celle rapportée par Cairn. Cette baisse ne signifie pas que les connaissances diffusées sur Érudit circulent moins, mais indique plutôt qu’une partie de leur circulation pourrait désormais échapper aux indicateurs dont nous disposons.
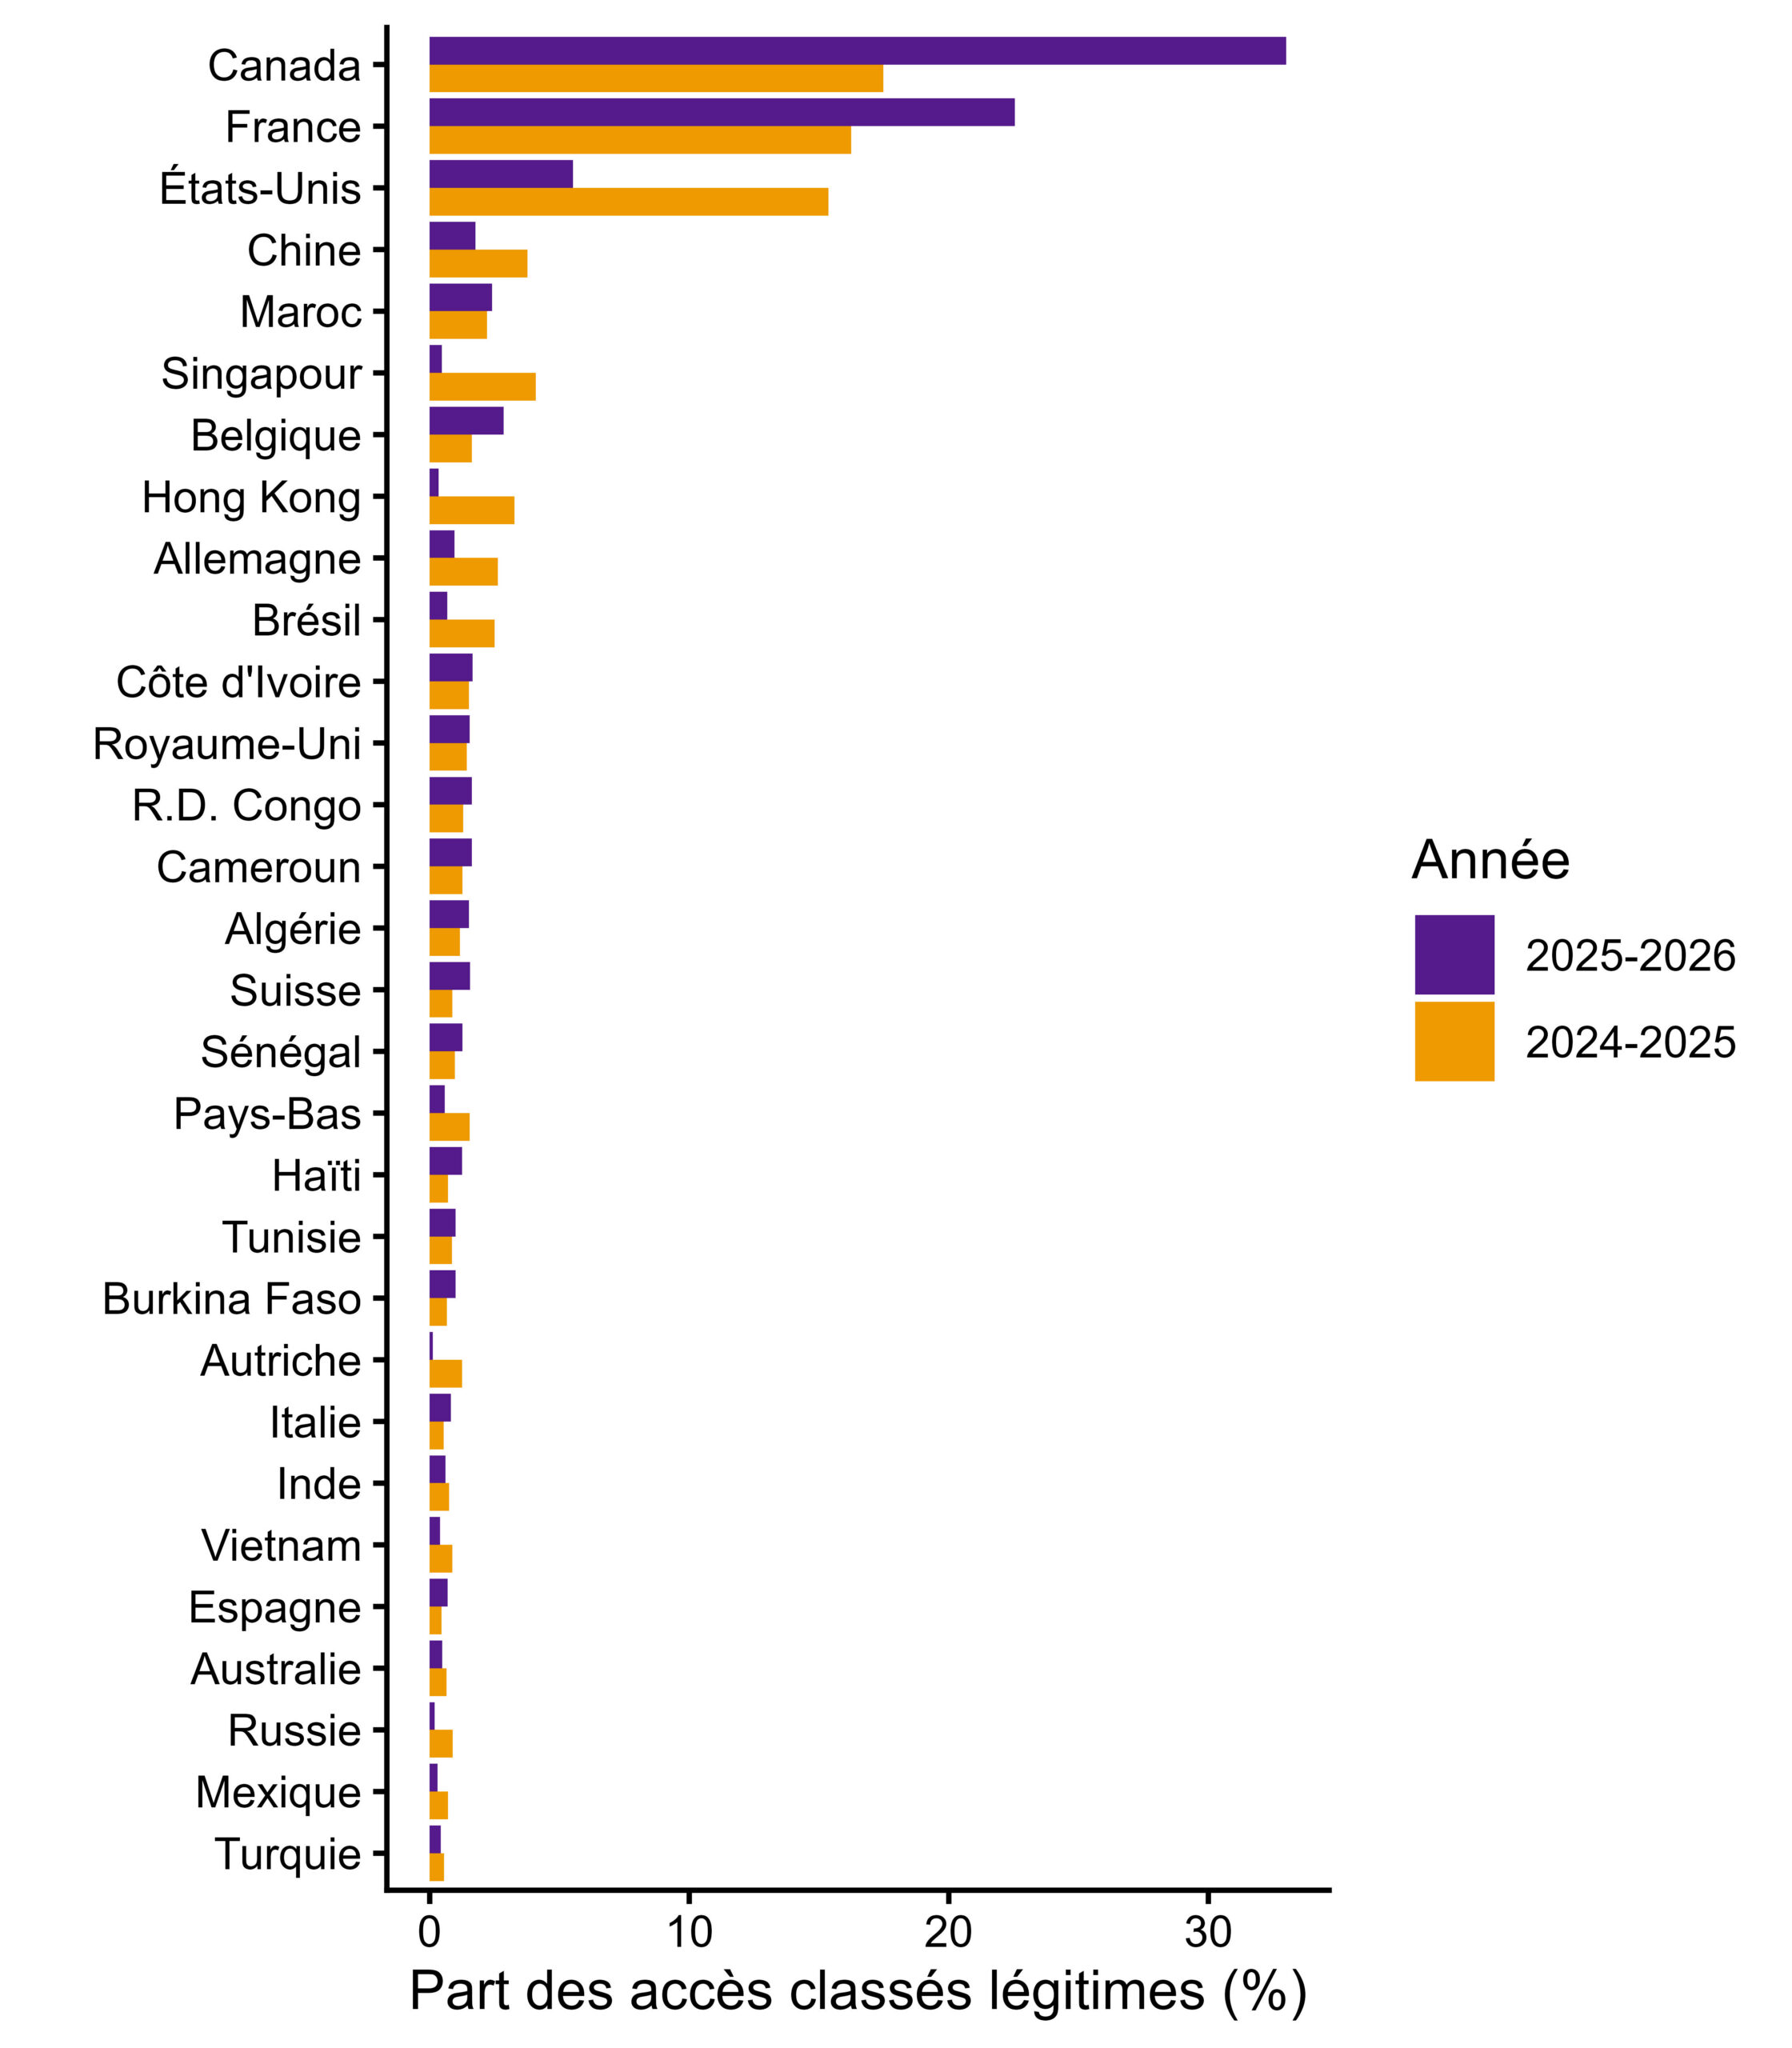
Une part importante des accès illégitimes provient d’un nombre relativement faible de pays, que nous avons identifiés à l’aide des adresses IP. En particulier, nous remarquons de forts nombres d’accès automatisés illégitimes provenant des États-Unis ainsi que de Singapour, de la Russie, du Brésil et de la Chine. Par conséquent, le filtrage accru en 2025-2026 change le portrait géographique de la consultation d’erudit.org (Figure 3). En 2025-2026, la part du Canada parmi l’ensemble des pays a augmenté nettement, tout comme celle de la France et d’autres pays hébergeant peu ou pas de robots, comme la Belgique, la Suisse et la plupart des pays africains francophones. À l’inverse, la part des pays associés à de nombreux accès illégitimes diminue.
Une particularité supplémentaire apparaît lorsque l’on quantifie le changement selon l’affiliation des internautes. La baisse des accès des personnes non abonnées est de 36 %, alors qu’elle reste limitée à 4 % chez les internautes associés à une institution abonnée. Cet écart pourrait être attribuable au niveau de familiarité ou d’engagement, voire un sentiment d’appartenance de la part des internautes ayant un accès par abonnement à Érudit – un trait qui pourrait être nettement moins présent chez les internautes non abonné·e·s, possiblement incluant un public non académique important.
Sur Érudit, les personnes qui consultent peuvent être classifiées « abonné·e·s » ou « non abonné·e·s » selon leur affiliation à une organisation abonnée au corpus, en fonction de l’adresse IP. Les internautes abonné·e·s sont donc lié·e·s à une des quelques 700 organisations abonnées ou partenaires d’Érudit, alors que les internautes non abonné·e·s ne le sont pas – ou ils et elles omettent l’usage du proxy de leur organisation.
Un chantier à poursuivre collectivement
Les usages de l’IA générative continuent d’évoluer, tout comme le comportement des robots qui parcourent les plateformes scientifiques. Depuis le déploiement d’Anubis, nous observons de nouvelles tentatives de contournement de nos mécanismes de protection. Nos équipes poursuivent donc leur travail pour mieux détecter ces accès automatisés, analyser les contenus bloqués et adapter continuellement nos méthodes afin de protéger la stabilité de notre infrastructure et la qualité de nos données.
En parallèle, nous travaillons à faire évoluer la manière dont nous mesurons et interprétons l’usage des publications scientifiques. La norme COUNTER explore notamment de nouveaux indicateurs permettant de mieux distinguer les consultations humaines de l’activité automatisée. Nos équipes de recherche et d’infrastructure technologique collaborent sur ces questions, qui seront au cœur de nos travaux au cours des prochaines années.
Cependant, ces transformations dépassent largement Érudit. Les revues, les bibliothèques et les autres plateformes de diffusion voient elles aussi évoluer la manière dont les connaissances sont découvertes et utilisées. Nous souhaitons travailler encore plus étroitement avec ces communautés pour partager nos observations, mieux comprendre ces nouveaux usages et réfléchir ensemble aux indicateurs dont nous aurons besoin demain. C’est en croisant nos expériences que nous pourrons continuer à rendre visible la circulation des savoirs et adapter nos modes de diffusion à cette nouvelle réalité.